Unser ML-Server: Warum es die NVIDIA RTX PRO 6000 Blackwell wurde
In diesem Beitrag
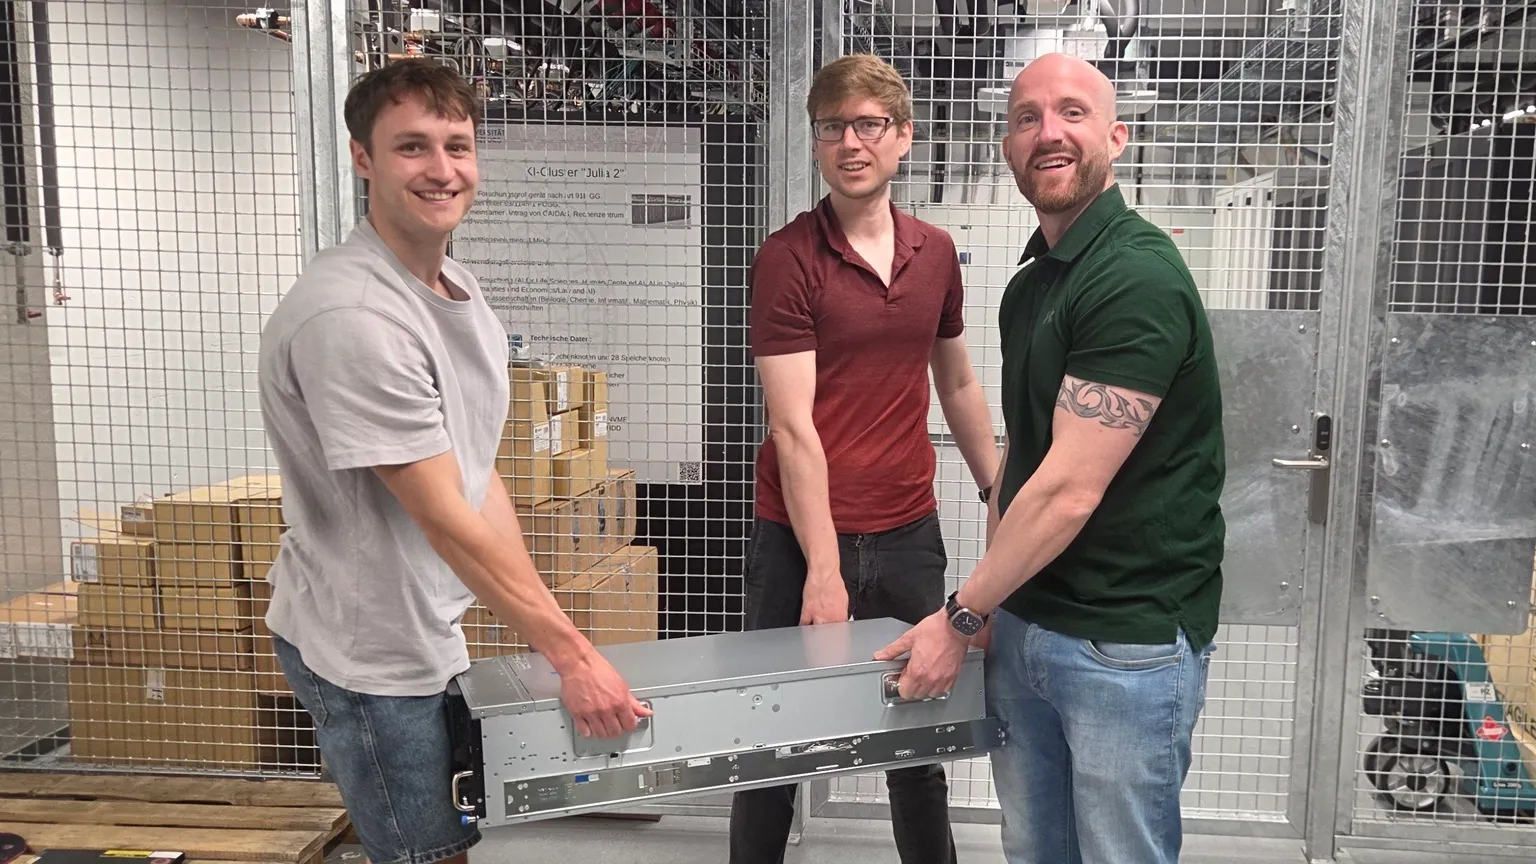
Im Juni 2026 haben wir unseren eigenen ML-Server in Betrieb genommen. Seitdem läuft darauf jedes Training, jedes Experiment und jede Inferenz für unsere Kunden. Die zentrale Entscheidung beim Aufbau war die Wahl der GPU — es wurde die NVIDIA RTX PRO 6000 Blackwell. Warum wir GPUs kaufen statt GPU-Stunden zu mieten, warum es genau diese Karte wurde und warum uns die fehlende NVLink-Verbindung nicht stört — darum geht es in diesem Beitrag.
Warum eigene GPUs
Die naheliegende Antwort für ein KI-Startup ist die Cloud: keine Anschaffung, keine Wartung, Rechenleistung auf Knopfdruck. Für uns haben drei Argumente gegen eine Cloud-Lösung gesprochen.
Datenhoheit. Wir arbeiten mit Absatz-, Bestands- und Bestelldaten unserer Kunden — Daten, aus denen sich Umsätze, Margen und Lieferantenbeziehungen ablesen lassen. Diese Daten verlassen unser Haus nicht. Sie werden auf unseren eigenen Karten verarbeitet, auf einem Server in Deutschland. Das ist kein Marketing-Argument, sondern für viele unserer Gespräche die Voraussetzung, überhaupt anzufangen.
Kosten bei Dauerlast. Gemietete GPUs rechnen sich, wenn man sie sporadisch braucht. Wir brauchen sie durchgehend: Trainings laufen nachts, Hyperparameter-Suchen laufen tagelang, Inferenz läuft ohnehin permanent. Bei dieser Auslastung amortisieren sich gekaufte Karten in einem überschaubaren Zeitraum — und danach kostet ein zusätzliches Experiment nur noch Strom.
Geschwindigkeit beim Ausprobieren. Der unterschätzte Punkt. Wenn eine GPU-Stunde Geld kostet, überlegt man zweimal, ob man ein Experiment startet. Wenn die Karten ohnehin im Rack stehen und gerade nichts tun, startet man es einfach.
Warum die RTX PRO 6000 Blackwell
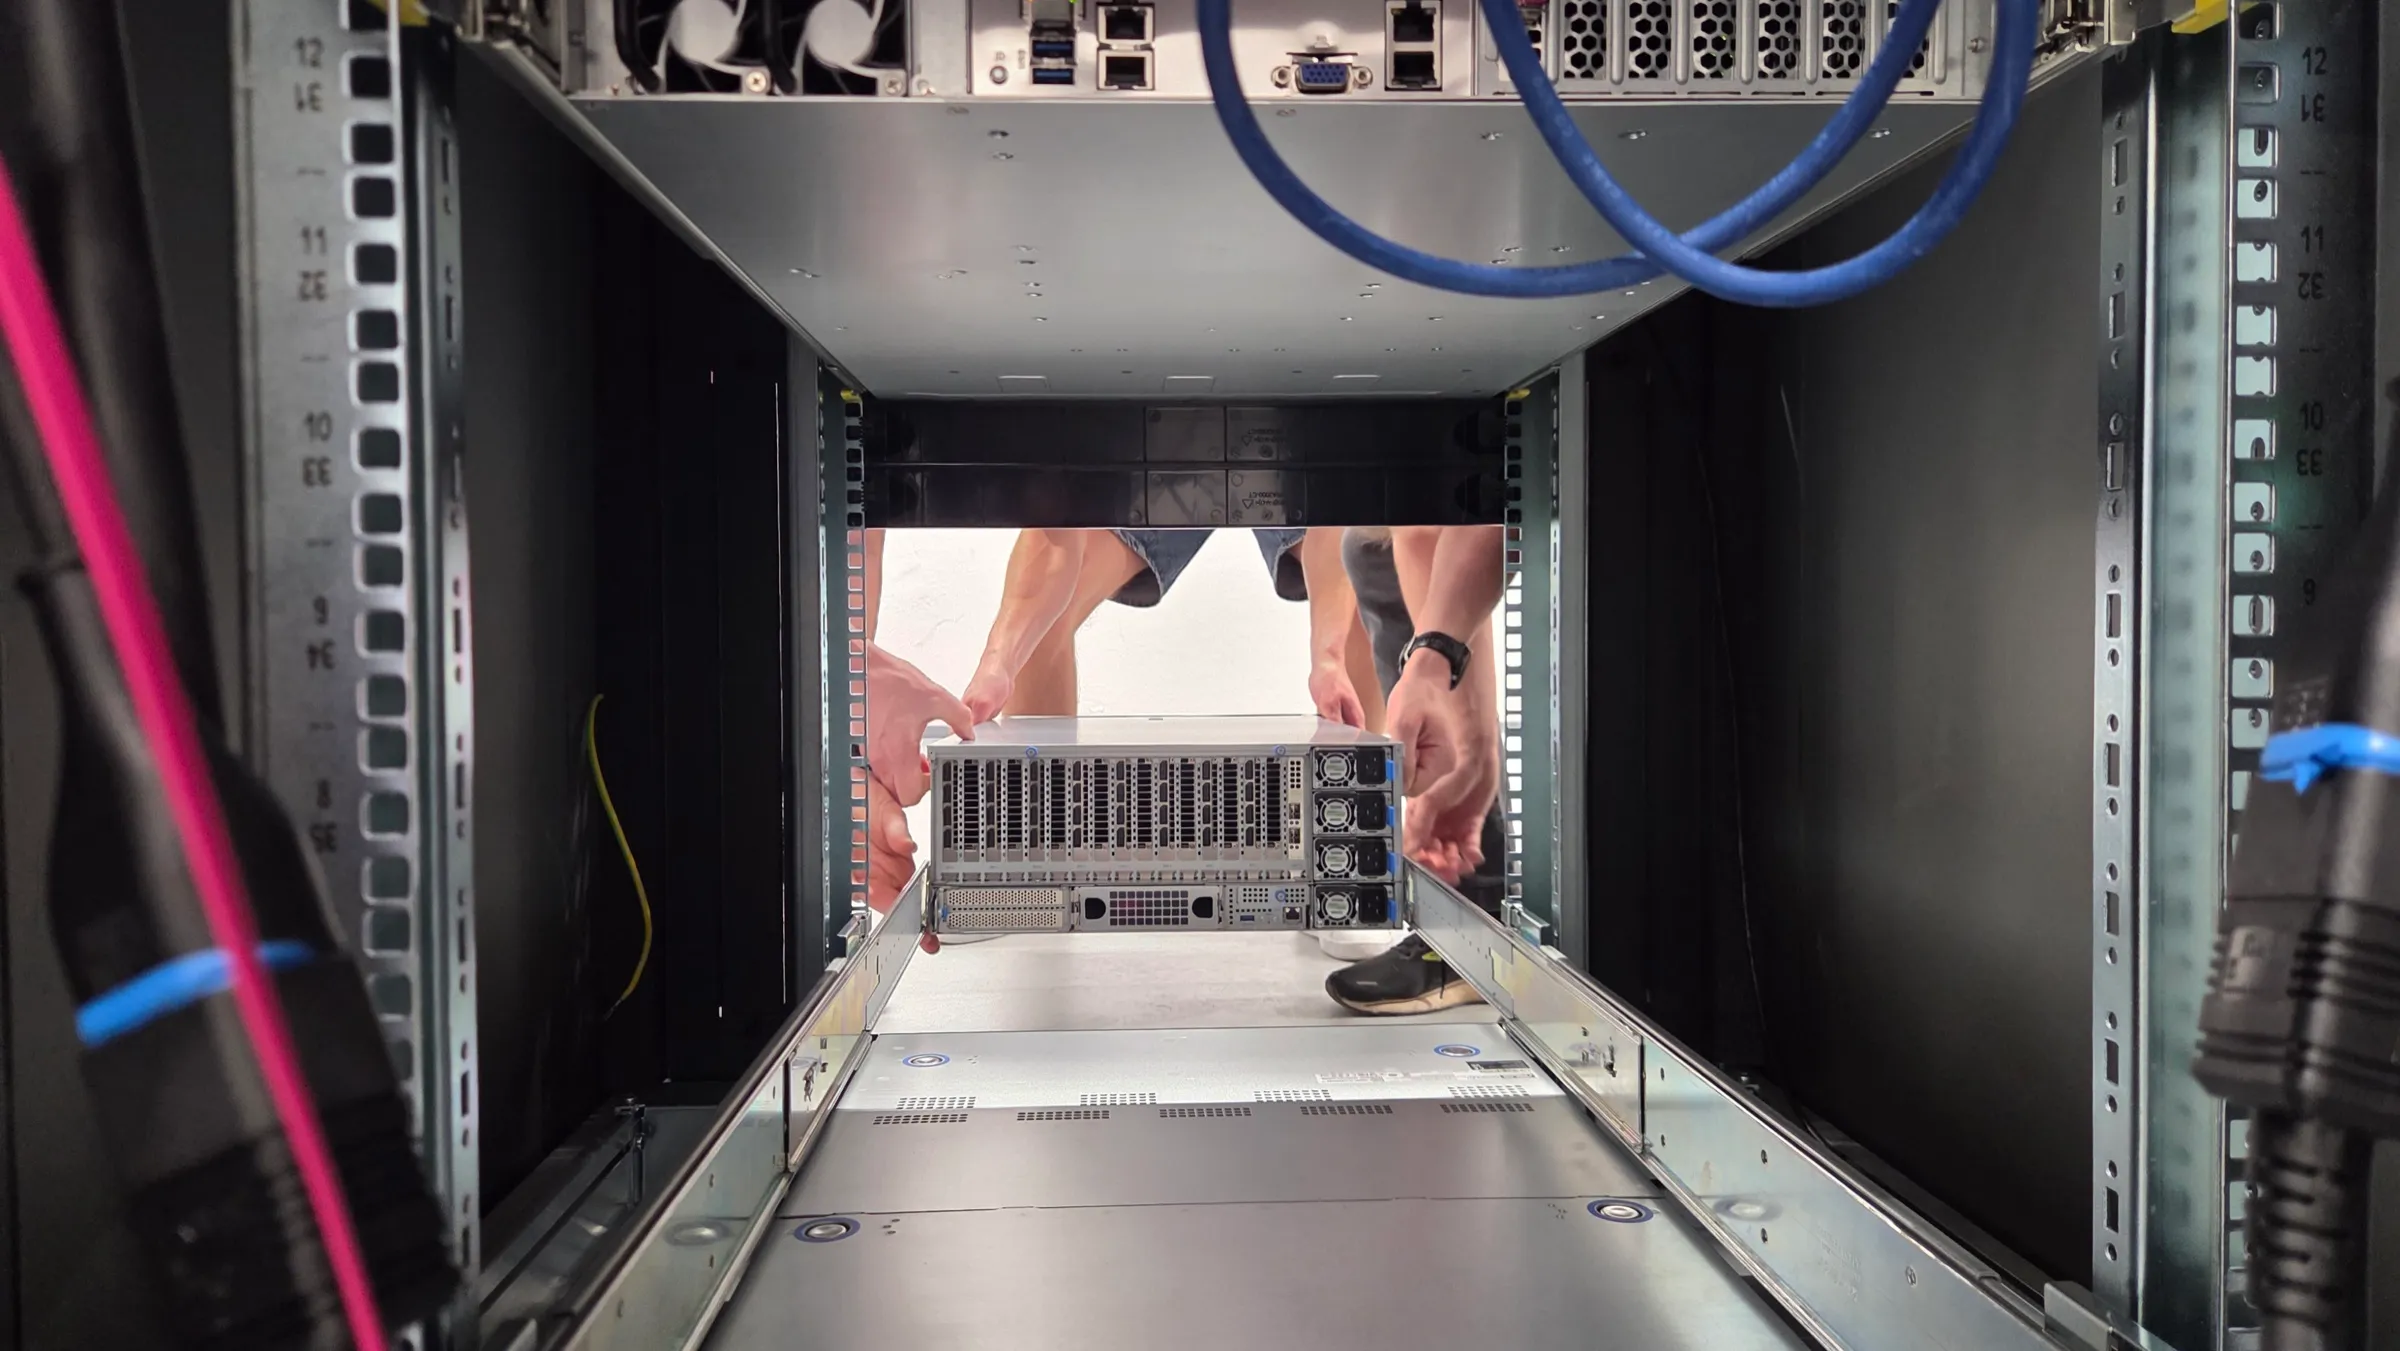
Die eigentliche Entscheidung war nicht „kaufen oder mieten”, sondern „welche Karte”. Die Kandidaten waren die üblichen Rechenzentrums-Beschleuniger — allen voran die NVIDIA H100 — und die RTX PRO 6000 Blackwell in der Server Edition, der passiv gekühlten Variante für den Rack-Einbau.
Die für uns entscheidende Zahl ist ihr Grafikspeicher: 96 GB GDDR7 mit ECC, angebunden über ein 512 Bit breites Interface. Warum ausgerechnet diese Zahl den Ausschlag gibt, wird weiter unten beim Thema NVLink klar — sie ist der Grund, warum wir uns eine ganze Klasse von Problemen sparen.
Ausschlaggebend war daneben das Verhältnis aus Rechenleistung, Speicher und Preis. Die Karte kostete uns zum Kaufzeitpunkt rund ein Drittel dessen, was ein vergleichbarer Rechenzentrums-Beschleuniger gekostet hätte — und bringt dabei mehr Speicher mit: 96 GB gegenüber 80 GB bei einer H100. Beim Durchsatz einer einzelnen GPU liegt sie in unabhängigen Vergleichen auf oder über dem Niveau der deutlich teureren Karte.
Das ist die entscheidende Rechnung: Für dasselbe Budget bekommen wir nicht eine, sondern drei Karten. Und drei Karten sind bei unserem Workload dreimal so viel gleichzeitiges Rechnen.
Was der RTX PRO 6000 fehlt, ist HBM — High Bandwidth Memory. Bei dieser Speichertechnik werden die Speicherchips gestapelt und sitzen direkt mit auf dem GPU-Package, angebunden über ein extrem breites Interface. Das bringt ein Vielfaches an Bandbreite, ist in der Fertigung aber deutlich teurer und einer der Hauptgründe für den Preis der Rechenzentrums-Karten: Eine H100 kommt so auf rund 3,4 TB/s, unsere Karte mit GDDR7 auf etwa 1,6 TB/s.
Diese Bandbreite entscheidet, wie schnell Gewichte und Zwischenergebnisse aus dem Speicher zur Recheneinheit kommen. Wichtig ist sie vor allem dort, wo pro Rechenschritt viel Speicher gelesen und wenig gerechnet wird — der Klassiker ist die Inferenz sehr großer Sprachmodelle, bei der für jedes einzelne Token sämtliche Gewichte durch den Speicher müssen. Unsere Time-Series-Modelle sind der umgekehrte Fall: viel Rechenarbeit pro geladenem Byte. Sie sind rechen-, nicht bandbreitenlimitiert — HBM wäre für uns ein Aufpreis ohne Gegenwert.
Warum wir kein NVLink brauchen
Der auffälligste Verzicht bei dieser Karte: NVIDIA hat NVLink bei der gesamten RTX-PRO-6000-Blackwell-Reihe gestrichen. Mehrere GPUs kommunizieren ausschließlich über PCIe Gen 5. In vielen Vergleichstests gilt das als das K.-o.-Kriterium für Training. Für uns ist es keins — und der Grund ist wichtiger als die Karte selbst.
NVLink löst ein bestimmtes Problem: Es beschleunigt den Datenaustausch zwischen GPUs, wenn ein Modell nicht auf eine einzelne Karte passt. Dann muss man es aufteilen — einzelne Tensoren oder ganze Layer auf verschiedene GPUs verteilen (Tensor- bzw. Pipeline-Parallelität). Bei diesem Vorgehen wandern in jedem einzelnen Rechenschritt Zwischenergebnisse zwischen den Karten hin und her. Ohne eine schnelle Direktverbindung wird die Verbindung zum Flaschenhals, und die GPUs warten mehr, als sie rechnen.
Wir müssen unsere Modelle nicht aufteilen. Unsere Time-Series Transformer passen mitsamt Optimizer-States und Aktivierungen vollständig in die 96 GB einer einzelnen Karte. Damit entfällt genau die Kommunikation, für die NVLink gebaut wurde. Bemerkenswert dabei: Weil die Karte mehr Speicher hat als die teurere Alternative, ist unser „passt auf eine GPU”-Spielraum sogar größer als er dort wäre.
Unsere Parallelität liegt eine Ebene höher — nicht im Tensor, sondern im Trainingslauf:
- Hyperparameter-Suche. Wir suchen systematisch nach Architektur- und Trainingsparametern. Das sind hunderte unabhängige Läufe, von denen viele gleichzeitig rechnen — einer pro Karte.
- Modelle pro Kunde und pro Sortiment. Verschiedene Datenbestände, verschiedene Modelle, kein gemeinsamer Zustand.
- Ablationen und Vergleiche. Dieselbe Frage mit fünf Varianten, alle parallel.
Verteilt werden diese Jobs über einen Slurm-Cluster, der sie einreiht und den freien Karten zuteilt. Eine Karte ist dabei dauerhaft für lokal betriebene Open-Source-Sprachmodelle reserviert — die laufen damit im eigenen Haus statt über eine fremde API.
In all diesen Fällen ist die Kommunikation zwischen den GPUs praktisch null. Jede Karte rechnet ihren eigenen Lauf, schreibt ihr Ergebnis in unser Experiment-Tracking und nimmt den nächsten Job. Eine Verbindung, die 900 GB/s zwischen zwei Karten schiebt, würde in diesem Bild schlicht nichts tun.
Anders gesagt: NVLink zu kaufen hätte bedeutet, für Bandbreite zu bezahlen, die unsere Jobs nie anfordern — und dafür ein Drittel so viele Karten zu bekommen.
Was wir dafür in Kauf nehmen
Diese Rechnung geht auf, solange die Annahme gilt. Sie hat klare Grenzen, und die benennen wir lieber selbst:
Ein Modell über 96 GB wird unangenehm. Ohne NVLink gibt es keinen gemeinsamen Speicherpool über mehrere Karten. Ein Modell, das nicht auf eine GPU passt, müssten wir über PCIe aufteilen — technisch möglich, aber spürbar langsamer. Sollten unsere Modelle irgendwann in diese Größenordnung wachsen, ist das eine Hardware-Entscheidung, keine Architektur-Entscheidung.
Klassisches Data-Parallel-Training über viele Karten ist nicht gratis. Wenn wir ein Modell über mehrere GPUs trainieren, müssen nach jedem Schritt die Gradienten zusammengeführt werden. Über PCIe kostet das echte Zeit. Bei unseren Modellgrößen ist der Effekt klein — aber er ist nicht null, und er wächst mit der Parameterzahl.
Umgekehrt gibt es auch Reserven, die wir noch nicht ausspielen. Die Server-Edition-Karten unterstützen MIG: Eine physische GPU lässt sich in bis zu vier logische Instanzen mit je 24 GB aufteilen. Für viele kleine, parallele Inferenz-Jobs wäre das der nächste Hebel — wir brauchen ihn im Moment nur nicht.
Was das für unsere Kunden bedeutet
Am Ende sind GPUs kein Selbstzweck. Drei Dinge werden dadurch konkret besser:
Erstens bleiben die Daten, mit denen wir arbeiten, in unserer Hand — verarbeitet auf unseren eigenen Karten, in Deutschland, ohne Umweg über eine fremde Cloud. Zweitens können wir Modelle pro Kunde trainieren, statt ein Einheitsmodell auf alle anzuwenden, weil zusätzliche Trainingsläufe uns nichts kosten außer Wartezeit. Und drittens probieren wir mehr aus. Das ist der Unterschied, der sich am schwersten beziffern lässt und am meisten ausmacht: Ein Team, das ein Experiment einfach startet, findet bessere Modelle als eines, das vorher rechnet, ob es sich lohnt.